Պրեպրինտում առաջարկվում է կարդալ դիֆուզիոն տրանսֆորմերների փոփոխվող կոնտեքստային տոկենները
arXiv-ի պրեպրինտում նկարագրվում է ընթերցող համակարգ, որը մուլտիմոդալ դիֆուզիոն տրանսֆորմերների ներքին կոնտեքստային տոկեններն արտապատկերում է սառեցված լեզվական մոդելին, որպեսզի այն կարողանա պատասխանել ձևավորվող պատկերի մասին հարցերին: Հեղինակները նշում են, որ ընդհանուր իմաստային տվյալները կարելի է կարդալ վաղ փուլում, իսկ մանրամասները՝ ավելի ուշ, ինչպես նաև առաջարկում են Contextual Alignment վարժեցման եղանակը: Այս արդյունքները մնում են միայն հեղինակների հայտարարությունների մակարդակում և քանակապես հիմնավորված չեն ներկայացված նյութերում. մեթոդները, չափանիշները, արդյունքները, սահմանափակումները, գրախոսությունն ու անկախ վերարտադրումը հաստատված չեն:
Այս թողարկումն անցել է «Իմանանք»-ի հրապարակման ընդլայնված ստուգումները: Որոշ էական պնդումներ շարունակում են հստակ վերագրվել պաշտոնական կամ ընկերության աղբյուրներին, քանի որ այս թողարկմանը դեռ անկախ աղբյուր կցված չէ: Համակարգը շարունակում է ստուգել հաստատված աղբյուրները և անկախ հաստատումը կավելացնի միայն ամբողջական ստուգում անցած նոր թողարկմամբ:
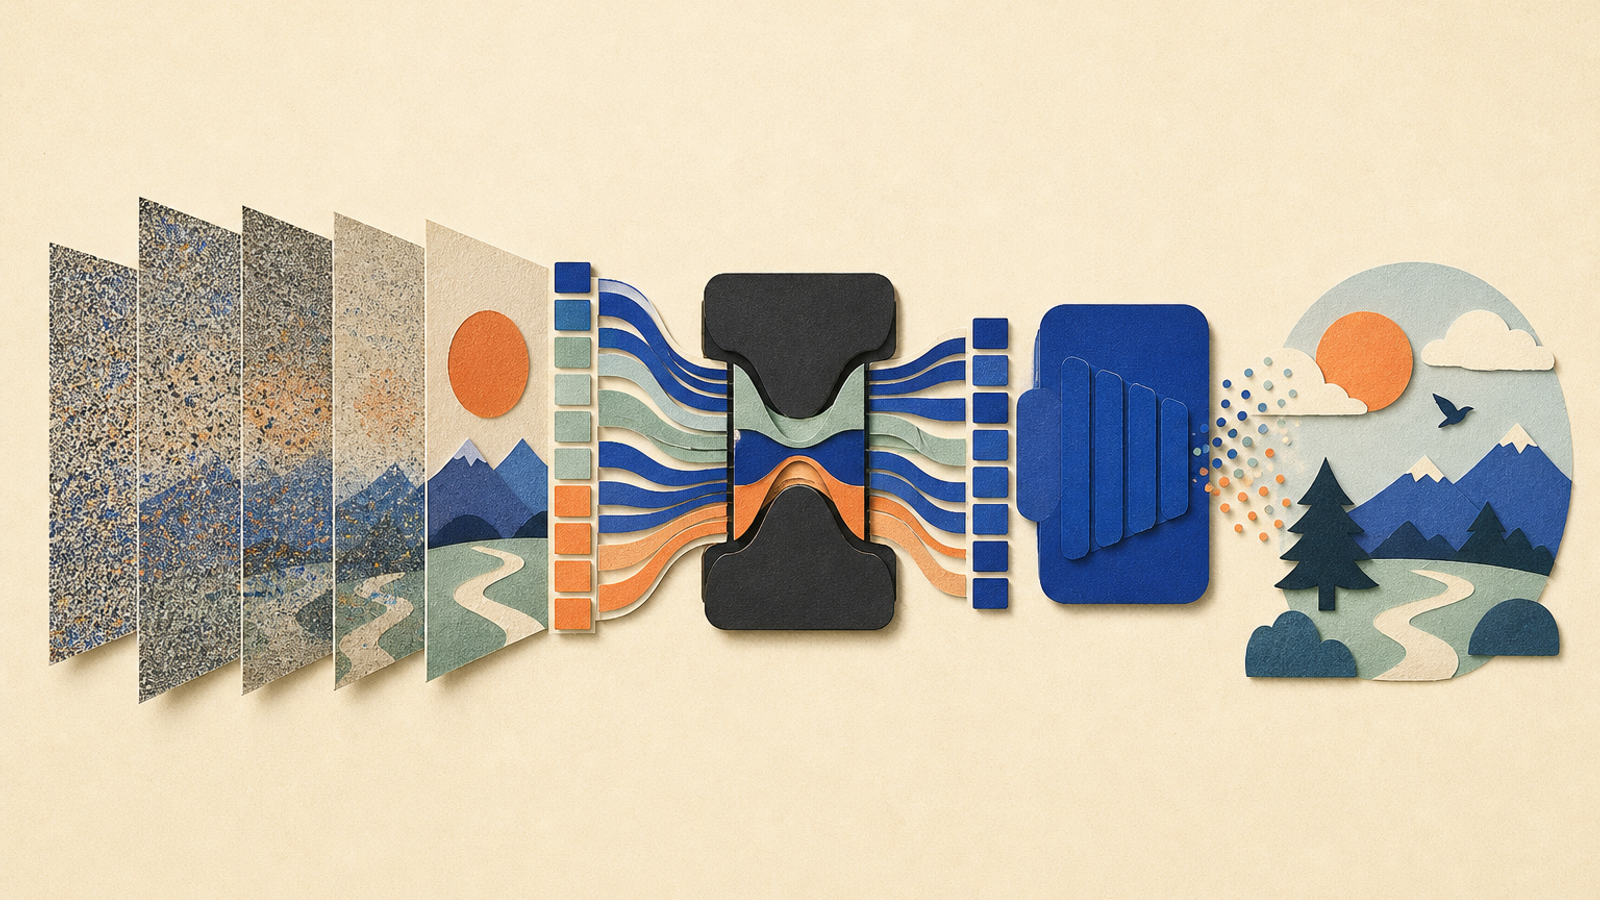
arXiv-ի նոր պրեպրինտում առաջարկվում է մեթոդ, որը թույլ է տալիս ուսումնասիրել մուլտիմոդալ դիֆուզիոն տրանսֆորմերների տեքստային ներքին ներկայացումները պատկերի գեներացման ընթացքում: Հեղինակների խոսքով՝ այդ կոնտեքստային տոկենները կարող են տեղեկություններ փոխանցել ձևավորվող տեսարանի մասին, սակայն տրամադրված նյութերում բացակայում են մանրամասն փորձարարական տվյալները, որոնք անհրաժեշտ են ճշգրտությունը, կայունությունն ու գործնական արդյունավետությունը գնահատելու համար: [1]
01
Ինչ գիտենք այս պահին
- 01
[1] arXiv, «Learning to Read the Contextual Tokens in Diffusion Transformers», տարբերակ 1, ներբեռնված 5 թվականի հոկտեմբերի 2026-ին՝ https://arxiv.org/abs/2610.06844v1:
- 02
Տրամադրված ամբողջական սկզբնական գրառումը պարունակում է հոդվածի սեղմագիրն ու մատենագիտական մետատվյալները, սակայն չի ներառում մանրամասն փորձարարական տվյալներ:
02
Հրապարակման կարգավիճակ
Աշխատանքը ներկայացված է որպես arXiv-ի 1 տարբերակ՝ ներբեռնված 5 թվականի հոկտեմբերի 2026-ին: Ներկայացված տվյալները չեն հաստատում գրախոսության փաստը:Առաջարկվող ընթերցող մոդուլ
Հեղինակները նկարագրում են թեթև bottleneck ցանց, որը միջանկյալ կոնտեքստային տոկենները կապում է սառեցված լեզվական մոդելի մուտքային տիրույթին:Ապակոդավորման հաղորդվող օրինաչափություն
Հեղինակների պնդմամբ՝ գեներացիային բնորոշ ընդհանուր իմաստային կառուցվածքը հասանելի է դառնում վաղ փուլում, իսկ ավելի մանրամասն տվյալները՝ denoising-ի ընթացքում:Գնահատման տվյալների մանրամասնություն
Հասանելի նյութերում բացակայում են տվյալների բազաները, ելակետային մոդելները, ընտրանքի ծավալները, սխալների հաճախականությունը և քանակական արդյունքները:Հոդվածում նկարագրված մեթոդի, հաղորդված օրինաչափության և փաստացի ապացույցների սահմանների համառոտ պատկեր:
03
Ինչ է հրապարակվել
Աղբյուրը հանդիսանում է arXiv-ի պրեպրինտ համակարգչային տեսողության ոլորտում, որը դասակարգված է նաև արհեստական բանականության, գրաֆիկայի և մեքենայական ուսուցման բաժիններում: arXiv-ում գրանցումը փաստում է հետազոտության հանրային ներկայացումը, սակայն ինքնին չի նշանակում գրախոսության անցկացում կամ անկախ հաստատում: [1]
- Հոդվածի վերնագիրն է՝ «Learning to Read the Contextual Tokens in Diffusion Transformers»:
- arXiv-ի գրառման մեջ որպես հեղինակներ նշված են Օմեր Դահարին, Էթայ Սելան, Հադար Ավերբուխ-Էլորը, Դանիել Քոեն-Օրը և Օր Պատաշնիկը:
- Աշխատանքը ներբեռնվել է arXiv 5 թվականի հոկտեմբերի 2026-ին՝ որպես 1 տարբերակ:
04
Հեղինակների առաջարկած մեթոդը
Հեղինակները նկարագրում են թեթև bottleneck ցանց, որի նպատակն է բնական լեզվով հարցումների միջոցով ընթեռնելի դարձնել մոդելի ներքին ներկայացումը: Ըստ նրանց՝ համակարգը չի պահանջում մեծ լեզվական մոդելի փոփոխություն. վարժեցված bottleneck կառուցվածքը դիֆուզիոն մոդելի միջանկյալ կոնտեքստային տոկեններն արտապատկերում է լեզվական մոդելի մուտքային տիրույթում: [1]
Սա հոդվածի սեղմագրից քաղված հետազոտական մեթոդի նկարագրություն է: Տրամադրված նյութերում չեն մանրամասնվում ճարտարապետության ընտրությունը, ուսուցման տվյալները, վարժեցման ընթացակարգը, համեմատվող այլ համակարգերը կամ այն պայմանները, որոնց դեպքում ընթերցիչը սխալներ է թույլ տալիս: [1]
- Մուլտիմոդալ դիֆուզիոն տրանսֆորմերները գեներացման ընթացքում վիզուալ և տեքստային ներկայացումները մշակում են համատեղ:
- Պարբերաբար թարմացվող տեքստային տոկենները հեղինակներն անվանում են «կոնտեքստային տոկեններ»:
- Նրանց առաջարկած ընթերցող մոդուլը միջանկյալ կոնտեքստային տոկեններն արտապատկերում է սառեցված մեծ լեզվական մոդելի մուտքային տիրույթին, որն այնուհետև պատասխանում է դեռևս գեներացվող պատկերի վերաբերյալ հարցերին:
05
Ինչ կարելի է պարզել ըստ պրեպրինտի
Հիմնական արձանագրված արդյունքը կապված է ժամանակային փուլերի հետ. ըստ հեղինակների՝ տվյալ գեներացվող պատկերի ընդհանուր իմաստային կառուցվածքը կոնտեքստային տոկեններում ի հայտ է գալիս denoising գործընթացի սկզբում, իսկ ավելի մանրամասն տեղեկությունները դառնում են ընթեռնելի գեներացման ընթացքին զուգահեռ: [1]
Սեղմագրում սա ներկայացվում է որպես ապացույց, որ կոնտեքստային տոկենները պարունակում են ձևավորվող տեսարանի հարուստ ընդհանուր պատկերը: Այս մեկնաբանությունը և ապակոդավորման նշված հնարավորությունը մնում են չստուգված, քանի որ տրամադրված նյութերում բացակայում են թեստավորման չափանիշները, ճշգրտության գնահատականները, օրինակները կամ սխալների վերլուծությունը: [1]
- Հեղինակների պնդմամբ՝ կոնտեքստային տոկեններից կարելի է ապակոդավորել տեսարանի ընդհանուր տեղեկությունները:
- Նրանք նշում են, որ հուշման (prompt) մեջ հստակ չնշված հատկանիշները կարող են ընթեռնելի լինել denoising-ի վաղ փուլում:
- Ավելի մանրամասն տվյալները, ըստ նրանց, հասանելի են դառնում ավելի ուշ:
- Հեղինակները նաև հայտնում են, որ տեղեկությունը հնարավոր է ապակոդավորել նույնիսկ դատարկ prompt-ի դեպքում, ինչը նրանք բացատրում են ձևավորվող վիզուալ ներկայացումից պատկերին բնորոշ տեղեկատվության կուտակմամբ:
06
Contextual Alignment-ը մնում է չհաստատված արդյունք
Բացի մեկնաբանությունից, հեղինակները Contextual Alignment-ը ներկայացնում են որպես վարժեցման եղանակ, որն ուղղված է կոնտեքստային տոկեններում վիզուալ առումով ավելի հարուստ տեղեկություն ստանալուն: Նրանք պնդում են, որ դա բարելավում է գեներացման որակն ու բաշխման ծածկույթը: [1]
Սեղմագիրը չի տրամադրում փոփոխությունների ծավալը, գնահատման ընթացակարգը, ելակետային չափանիշները կամ մարդկային նախասիրության չափման տվյալները: Հետևաբար, այս գրառման հիման վրա ընթերցողները չեն կարող դատել, թե որքանով է նշված արդյունքը կամ վարժեցման ազդեցությունը մեծ, ընդհանրացվող կամ վերարտադրելի: [1]
- Հեղինակները ներկայացնում են վարժեցման նոր մեթոդ՝ Contextual Alignment անվամբ:
- Նրանց պնդմամբ՝ այն ամրապնդում է վիզուալ-իմաստային տեղեկատվությունը կոնտեքստային տոկեններում:
- Հաղորդվում է գեներացման որակի և բաշխման ծածկույթի բարելավման մասին:
- Նշվում է նաև, որ ավելի հստակ ընթեռնելի կոնտեքստային ներկայացումներ ունեցող պատկերները սովորաբար ստանում են մարդկային նախասիրության ավելի բարձր գնահատականներ:
07
Ինչու է այս տարբերակումը կարևոր
Պատկերների գեներացիայի հետազոտություններին հետևողների համար այս աշխատանքը հետաքրքիր է, քանի որ փոփոխվող տեքստային տոկենները դիտարկում է որպես պատկերի մասին տեղեկատվության հնարավոր աղբյուր՝ մինչև գեներացման ավարտը: Մանրամասն փորձերով և վերարտադրմամբ հաստատվելու դեպքում սա կարող է կարևոր նշանակություն ունենալ մոդելների մեկնաբանելիության և ուսուցման նպատակների հետազոտության մեջ: [1]
Առայժմ հիմնավորված հետևությունն ավելի զուսպ է. հեղինակները հրապարակել են պրեպրինտ, որտեղ նկարագրում են ընթերցող համակարգ և հայտնում խոստումնալից դիտարկումների մասին: Դրա արդյունավետությունը, սահմանափակումները և կիրառելիությունը հեղինակների գնահատումից դուրս մնում են անհայտ առկա նյութերի հիման վրա: Հիմնական աղբյուրը arXiv-ի գրառումն է՝ https://arxiv.org/abs/2610.06844v1 [1]
- Աշխատանքն առաջարկում է հնարավոր հետազոտական ուղղություն՝ դիֆուզիոն գեներացման ընթացքում ներքին վիճակներն ուսումնասիրելու համար:
- Այն դեռևս չի հանդիսանում հուսալի ախտորոշիչ գործիք, համապարփակ մեկնաբանման տեխնիկա կամ բոլոր մոդելների համար երաշխավորված բարելավում:
- Սկզբնաղբյուրի գրառումը հղում է ամբողջական հոդվածին, սակայն ներկայացված նյութերը չեն հաստատում գործնական ծրագրային կոդի կամ տվյալների հասանելիությունը:
08
Ինչ կարող են անել ընթերցողները
Հոդվածը պետք է դիտարկել որպես հետազոտական նախնական հայտարարություն, ոչ թե ստուգված գործիք կամ պատրաստի արտադրական լուծում:
- 01
Ծանոթացեք arXiv-ի սկզբնական գրառմանը և, անհրաժեշտության դեպքում, կցված ամբողջական հոդվածին՝ մեթոդներն ու փորձարարական տվյալներն ուսումնասիրելու համար:
- 02
Հետևեք՝ արդյոք հասանելի կդառնան հաջորդող տարբերակները, գրախոսությունները, ծրագրային կոդը, տվյալների բազաները կամ անկախ վերարտադրությունները:
- 03
Մինչև մեթոդի կիրառումը, նշված բոլոր արդյունքները համեմատեք հոդվածի տվյալների բազաների, ելակետային մոդելների (baselines), չափանիշների ու հնարավոր սխալների (failure cases) հետ:
09
Այս թողարկման սահմանափակումները
Սա մեկ պրեպրինտի հրապարակում է, որը չի հանդիսանում գրախոսության կամ անկախ վերարտադրման ապացույց: [1]
Տրամադրված նյութերը չեն պարունակում ամբողջական մեթոդաբանությունը, տվյալների բազաները, ելակետային մոդելները, չափանիշները, ընտրանքի ծավալները, սխալների հաճախականությունը կամ արձանագրված անհաջող դեպքերը: [1]
Փաստաթղթերում առկա չէ ծրագրային կոդը, մոդելը, տվյալների բազան կամ նախագծի հաստատված պաշտոնական էջի հղումը: [1]
Պատկերի որակի, բաշխման ծածկույթի և մարդկային նախասիրությունների վերաբերյալ պնդումները նշված են հեղինակների սեղմագրում և ներկայացված նյութերում չունեն քանակական հիմնավորում: [1]
SRC
Աղբյուրների բաժին
Ուղիղ հղումներ այս ընտրանու հիմքում եղած նյութերին: Աղբյուրը տեսնելը նույնքան կարևոր է, որքան սինթեզն ընթերցելը:
Շարունակել ընթերցումը
30 սեպ, 2026 թ.
Imagine3D-LLM-ն առաջարկում է պատասխանից առաջ կառուցել 3D տեսարանի կոմպակտ պատկերացում
arXiv-ի պրեպրինտը նկարագրում է մուլտիմոդալ լեզվական մոդելի ուսուցումը, որը պատասխանելուց առաջ բազմադիտակետ պատկերներից կազմում է 3D Gaussian Splatting կոմպակտ ներկայացում: Հեղինակները նշում են թեստերում բարելավված արդյունքների մասին, սակայն սեղմագիրը չի պարունակում կոնկրետ ցուցանիշներ կամ թեստերի անվանումներ և չի ապահովում պնդումների անկախ հաստատում:
6 սեպ, 2026 թ.
SBS պրեպրինտն առաջարկում է տեսողական ուղղորդմամբ անցումների հայտնաբերում խիտ ենթագրավորման համար
SBS-ը հեղինակների կողմից նկարագրված պրեպրինտային մեթոդ է, որն օգտագործում է տեսալեզվական մոդելների կադրային նկարագրությունները՝ տեսանյութի իրադարձությունների միջև անցումները գտնելու և ժամանակային սահմանները ճշգրտելու համար: Հեղինակները հայտնում են երկու շտեմարանում գրանցված առաջատար արդյունքների մասին, սակայն arXiv-ի էջում թվային տվյալներ, կոդ կամ անկախ գնահատականներ չկան:
1 հոկ, 2026 թ.
Պրեպրինտը պնդում է, որ դասակարգման վրա հիմնված հուշումների որոնումը կարող է ավելի լավ թիրախավորել AUROC-ը, քան ճշգրտությունը
Հեղինակներն առաջարկում են Ranking-PE մեթոդը՝ հուշումների էվոլյուցիայի մոտեցում, որն առանձին դեպքերի ճշտությունը փոխարինում է զույգերի դասակարգման արդյունքներով, որպեսզի թեկնածուների ընտրությունը թիրախավորի էմպիրիկ AUROC-ը։ Նրանք նշում են բարելավումներ ճշգրտության վրա հիմնված մեթոդի համեմատ MIMIC-ի վրա երեք հիվանդությունների փորձարկումներում, սակայն այս պնդումները վերցված են չգրախոսված պրեպրինտից, իսկ գնահատման կարևոր մանրամասները տրամադրված նյութում բացակայում են։